本地語音轉文字模型比較
我平常在本機用 Whisper(OpenAI 開源的語音辨識模型)轉逐字稿,已經用到 large-v3 了,還是覺得不太精準。所以想試試看有沒有其他模型可以更準。
手上剛好有一段 97 分鐘的錄音,是我跟一位學長聊產品方向的對話。我把前 10 分鐘切出來,同一段音訊丟給六個語音辨識模型,在一台 M1 Pro(32 GB)上依序跑完,全程不連網。
測下來,效果都跟我預期的有落差,沒有哪一個明顯比 Whisper 準到可以直接用。
意外的是錄音中間那兩分多鐘:主要對話停了、背景只剩別人的聲音,六個模型給了三種完全不同的答案——三個鬼打牆重複同一句、一個直接留白、兩個寫出一整段跟我們無關的內容。速度也差了 70 倍,最快 4 秒、最慢將近 5 分鐘。
這篇分享:六個模型的速度跟記憶體、中英夾雜的詞誰聽得對,以及目前本機語音轉文字(STT)能做到哪裡。
六個模型,全部關掉網路跑
這次的六個:
- Whisper large-v3 和 large-v3 turbo(turbo 是縮小加速版),用 MLX(Apple 自己的機器學習框架)跑在 GPU 上
- Qwen3-ASR-1.7B(阿里巴巴的語音辨識模型),一樣走 MLX
- SenseVoiceSmall、Paraformer-zh(兩個都是阿里 FunASR 家族)、FireRedASR2-AED(小紅書開源的中文模型),走 PyTorch(另一套機器學習框架)跑在 MPS(Mac 的 GPU 加速)
每個模型的 Python process 都把對外連線關掉,權重從本機快照載入。音訊統一轉成 16 kHz,切成 26 段、每段 20 多秒送進去。
10 分鐘錄音,最快 4 秒、最慢將近 5 分鐘
| 模型 | 跑完 10 分鐘花多久 | RTF | 記憶體峰值 |
|---|---|---|---|
| SenseVoiceSmall | 3.8 秒 | 0.006 | 3.1 GiB |
| Paraformer-zh | 4.7 秒 | 0.008 | 3.0 GiB |
| Whisper large-v3 turbo | 60 秒 | 0.10 | 2.0 GiB |
| Qwen3-ASR-1.7B | 74 秒 | 0.12 | 4.1 GiB |
| Whisper large-v3 | 94 秒 | 0.16 | 3.8 GiB |
| FireRedASR2-AED | 278 秒 | 0.46 | 9.2 GiB |
RTF(real-time factor)是「處理時間 ÷ 音訊長度」,越小越快。0.1 就是 10 分鐘的錄音 1 分鐘轉完。
SenseVoice 和 Paraformer 快到有點不合理,整段 97 分鐘的錄音大概一分鐘內就能轉完。FireRed 是另一個極端,記憶體一度吃到 9.2 GiB,16 GB 的 Mac 跑它會很吃力。
6:46 到 9:07,六個模型給了三種答案
這段錄音從 6:46 開始,我們兩個的對話停下來,背景只剩別人講話的聲音,一直到 9:07 左右才回到正題。[TODO: 確認這段現場在做什麼(換場地?旁邊有人在聊天?)]
六個模型在這兩分多鐘的表現:
- 鬼打牆:Whisper large-v3 把「有的很優秀」連續寫了 22 次;turbo 寫了 64 次「您好」;FireRed 是一串「好的好的好的」
- 直接留白:SenseVoice 整段只輸出幾個句點
- 寫出一整段內容:Qwen 和 Paraformer 都寫出了跟我們對話無關的東西,有遊戲、有買衣服。兩邊的內容有幾處對得上,看起來真的有人在旁邊講這些,只是離麥克風很遠
這就是語音辨識說的 hallucination(幻覺,模型在沒有清楚語音的地方自己生出文字)。重複同一句是 Whisper 家族很有名的毛病,這次 FireRed 也中了。
哪一種比較好,要看你要什麼。做會議紀錄,我寧願要 SenseVoice 那種留白;如果想知道現場到底有誰在講什麼,Qwen 反而抓到最多資訊。
開頭 25 秒,SenseVoice 只聽到一個字
第一段 0 到 25 秒,其他模型都寫出了一整段對話,SenseVoice 只輸出一個「錄」字。
後面的段落它表現正常,所以不是整個模型壞掉,比較像是對某些開頭的聲音特別敏感。只看速度會覺得它是首選,但這種「整段消失」在會議紀錄裡是很危險的——你不會知道少了什麼。
中英夾雜:agent 和 Jarvis 誰聽得對
錄音裡我講了好幾次 agent,也提到 Jarvis(鋼鐵人裡的 AI 管家)。六個模型寫出來的樣子:
| 模型 | agent | Jarvis |
|---|---|---|
| Whisper large-v3 | agent ✅ | Jarvis ✅ |
| Whisper turbo | agent ✅ | Jarvis ✅ |
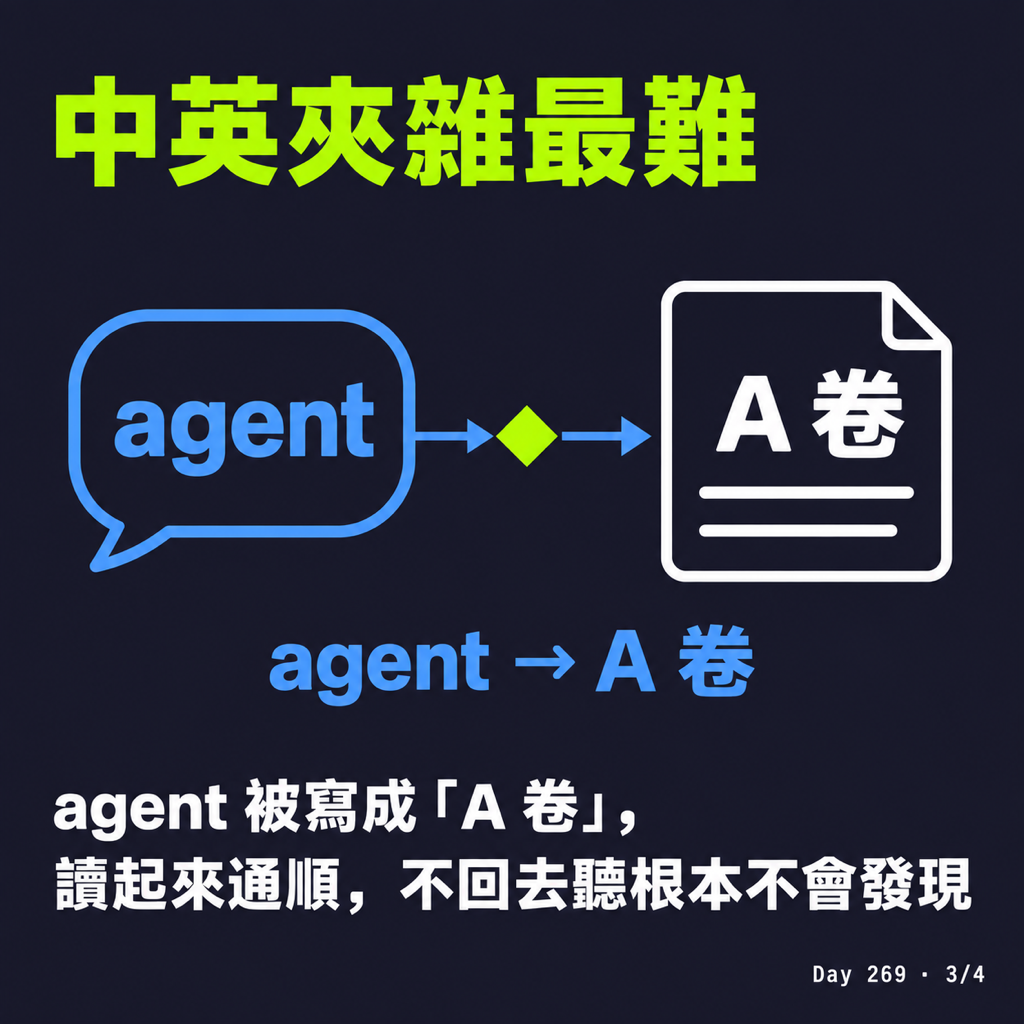
| Qwen3-ASR | 多數寫成「A 卷」 | Jarvis ✅ |
| FireRed | 全部寫成「a卷」 | javas |
| SenseVoice | agA、A卷 | vis |
| Paraformer | 部分寫對 | 沒寫出來 |
最後一句我舉了兩個模型服務當例子,第一個應該是 ChatGPT。[TODO: 確認第二個講的是什麼]其他五個模型寫出來分別是 TradeGP、去GPT、去GPT、gbt、GPD——Qwen 則寫成「Transformer 或是 NLP」,聽起來很合理,但跟其他五個對不上。
這種錯最麻煩:它讀起來很通順,不回去聽根本不會發現。
輸出幾乎都是簡體,要自己再轉一次
六個模型的原始輸出,除了 Whisper 偶爾吐繁體,其他大多是簡體。
這次的流程用 OpenCC(開源的簡繁轉換工具,Day 231 介紹過)的 s2t 設定轉成繁體,結果留下「因爲」「裏面」這些台灣不用的字。還有一句「太粗糙了然後」變成「太粗糙瞭然後」——OpenCC 把「了然」當成一個詞,轉成了「瞭然」。
我把同一句丟給三種設定比較:
from opencc import OpenCC

text = '就现在这个都还太粗糙了然后 因为 里面 账号'
for config in ['s2t', 's2tw', 's2twp']:
    print(config, OpenCC(config).convert(text))

# s2t   就現在這個都還太粗糙瞭然後 因爲 裏面 賬號
# s2tw  就現在這個都還太粗糙瞭然後 因為 裡面 賬號
# s2twp 就現在這個都還太粗糙瞭然後 因為 裡面 賬號
換成台灣用字的 s2tw 或 s2twp,「因為」「裡面」就對了,但「賬號」和「瞭然」三種設定都修不掉。逐字稿轉完繁體,還是要再掃一次。
那到底誰辨識得比較準
這段 10 分鐘的錄音沒有人工逐字稿,所以我沒辦法給出「誰的錯字率最低」這種數字,這段的準確度只能先空著。
能做的是把六份結果放在一起看。六個模型寫得差不多的地方,大致可以相信;分歧的時候就需要多加檢查。這次分歧最大的,就是那兩分多鐘的背景雜音和那幾個英文詞。
要算出準確度,得有標準答案。所以我另外準備了一組 99 筆的測試語音,大部分是合成的(用 macOS 內建的語音念出寫好的稿子),分成純中文、台灣聲線、中英夾雜、縮寫、靜音和噪音幾類,六個模型都跑一次。
純中文的部分沒有差距:六個模型的錯字率(CER)都不超過 0.7%。差距全部出在英文和靜音:
| 模型 | 中英夾雜的英文錯誤率 ↓ | 指定英文術語答對 ↑ | 縮寫答對(40 筆)↑ | 靜音/噪音亂吐字(10 筆)↓ |
|---|---|---|---|---|
| Qwen3-ASR-1.7B | 26.5% | 82.7% | 77.5% | 0 |
| Whisper large-v3 | 16.2% | 80.8% | 52.5% | 9 |
| FireRedASR2-AED | 35.3% | 67.3% | 82.5% | 0 |
| Whisper turbo | 39.7% | 65.4% | 55.0% | 9 |
| Paraformer-zh | 47.1% | 55.8% | 45.0% | 10 |
| SenseVoiceSmall | 63.2% | 48.1% | 62.5% | 10 |
英文錯誤率是 WER(以英文單字為單位算錯了幾個),縮寫是 API、GPU、OAuth 這類詞。
如果一定要選一個:
- 不知道選哪個就用 Qwen3-ASR:英文術語答對最多,縮寫第二,靜音時一個字都不亂吐,速度也在中間。這是我目前的預設
- 英文句子很多:Whisper large-v3 的英文錯誤率最低,但靜音時 10 筆有 9 筆會亂吐字,前面這段真人錄音的鬼打牆也是它
- 全是中文、要快:SenseVoice 或 Paraformer,10 分鐘 5 秒內轉完;代價是英文最弱、合成測試的靜音/噪音樣本一定會吐東西,還要留意整段漏掉
- 縮寫特別多:FireRed 縮寫答對率最高,但它最慢、也最吃記憶體
要說清楚的是,這些合成語音的標準答案就是當初寫的稿子,還沒有人逐字聽過校對;macOS 的台灣聲線也不等於真的台灣人講話。真人錄音上誰最準,目前還判定不了。
回到我一開始的問題:有沒有比 Whisper large-v3 更準的本機模型?這次的答案是沒有明顯更準的。英文術語、背景雜音、開頭漏字,每個模型都有自己的問題。Day 230 那次也一樣,原始轉錄要再過一次 LLM(大型語言模型),把「嗯、呃、啊」、口吃和破碎句清掉,才變成能讀的逐字稿。
什麼情況不適合用這幾個
- 需要時間戳記:這次的設定裡,SenseVoice 和 Qwen 都沒有逐字的時間戳記,要做字幕得另外對齊
- 需要標點:Paraformer 輸出的是一個字一個空格、完全沒有標點的長串,要自己再過一次 LLM
- Mac 記憶體只有 8 GB 或 16 GB:FireRed 峰值 9.2 GiB 就別考慮了,turbo 的 2 GiB 最輕
- 錄音有長段靜音或背景雜音:Whisper 家族很容易鬼打牆。可以先過 VAD(語音活動偵測,把沒人講話的段落切掉),不過這次沒開,還沒量過能改善多少
目前的 STT 搭配 LLM,抓得到大概的意思,但還不能要求精準。
Day 230 ASR 已經夠用:https://www.dawsonwang.com/day/230 Day 231 其實用 OpenCC 就好了:https://www.dawsonwang.com/day/231 Whisper large-v3 MLX:https://huggingface.co/mlx-community/whisper-large-v3-mlx