什麼是 Jev?為什麼我覺得它過譽了?實測數據分享
Jev 這幾天在開發者社群很熱,轉發的人很多,倍數拿出來講的也很多。TypeSafe 九月中把它推出來,官方數字是快 193.6 倍、便宜 444.6 倍,成績單上跑完一個完整流程 $0.0004。
我自己把它的成績單重跑了一遍,也去翻了別人做的獨立測試。Jev 有它的價值,只是跟大家在轉的那些倍數不是同一件事。
這篇分享:Jev 到底是什麼、「便宜 444 倍」這種比法的問題在哪、我實際重跑成績單看到什麼,以及我覺得它該擺在什麼位置。
先講 Jev 是什麼:它是一個分類器
它做的事,是在一組你事先就定好的選項裡挑一個。你給它一段輸入,它告訴你這段輸入該被分到哪一格。
像一個人跟你說他幾月幾號生日,你就知道他是什麼星座——可能的答案就固定那 12 個,你要做的只是把輸入對到其中一格。Jev 做的是同一件事,只是輸入從生日換成一段文字。
你只能用三種方式問它:
| 你問它 | 它回你 |
|---|---|
| 是非題 | 一個機率。「這是真的入侵嗎」→ 0.38 |
| 選擇題 | 一個選項,附上每個選項的機率。「影響範圍」→ 只有一台 |
| 評分題 | 一個分數。「證據強度 0 到 3 分」→ 1.31 分 |
最典型的用途是客服分流。一件客訴進來,下一步的可能性是有限的:用罐頭訊息直接回、轉真人、退款、升級。這種「選項就那幾個,而且你完全知道有哪幾個」的情況就是它的主場——丟進去,它很快告訴你這件該走哪一條。
既然是分類器,它當然不生成文字。不寫回覆、不寫程式、不解釋理由。它連輸出都不收你錢,因為它根本沒有字要寫。
(TypeSafe 把這類模型叫 System One,名字來自康納曼《快思慢想》裡負責快、直覺的那一半;Jev 這個名字則是取自經濟學家傑文斯。公司的共同創辦人兼執行長 Diogo Almeida 是前 OpenAI 研究員、RLHF 跟 ChatGPT 的共同發明人之一,兩年前離開 OpenAI 出來創業,九月結束隱身模式,帶著 4000 萬美元的種子輪資金正式亮相。)
「便宜 444 倍」根本沒得比
官方那組 193.6 倍快、444.6 倍便宜,並沒有點名比的是誰,只說這組數字來自它自家的評測,而且是「實際效益的高標」。
一個只做分類的模型,跟一個要生成整段文字的模型比每次呼叫的成本,這個比法本身就站不住腳。Jev 快,是因為當初就只訓練它做這一件事。
就像我們不會拿本地跑的語音轉文字模型去跟 ChatGPT 比速度跟成本。前者當然壓倒性地贏,但那不代表它能取代後者——兩邊根本不在做同一件事。
要比,只能比同樣一個分類問題交給我們平常在用的 ChatGPT、Claude,結果差多少。
這個比法有人做過。英國活動網站 Near Here 拿 Jev 跟 Mistral Small 4、Gemini 3.5 Flash-Lite 比「這筆活動該不該收」,50 個案例:
| 模型 | 答對幾題 | 每筆要多久 | 判斷 1000 次的成本 |
|---|---|---|---|
| Jev 1.13.0 | 48/50 | 0.6 秒 | $0.043 |
| Gemini 3.5 Flash-Lite | 43/50 | 3.4 秒 | $2.496 |
| Mistral Small 4 | 42/50 | 2.9 秒 | — |
Jev 確實贏。但同場比出來的差距,對 Mistral Small 4 是快 5 倍、便宜 8.6 倍,對 Gemini 3.5 Flash-Lite 是快 5.7 倍、便宜約 58 倍,跟官方那組 193 倍、444 倍完全不是同一個數量級。
我自己去驗了它的成績單
TypeSafe 有個公開的成績單網站,四項任務,Jev 綜合 67.8%。我挑其中一項來驗:系統跳出一則資安警報,判斷要直接關掉、排進佇列交給分析師、通知使用者、還是馬上處置。Jev 在這項考了 61.7%,總共 240 題。
官方的 API key 我今天凌晨才拿到,拿到後就照網站公開的資料,把它的判斷流程整個重建了一遍,真的打一次 API 重考。
先講好消息:數字沒有造假。 網站公開的那幾題,我重跑出來的答案跟它貼的一模一樣;它標的成本跟速度,我另外算過也對得上。
但有三件事,看完我對那個 61.7% 的信心就下降了。
一、240 題只公開 5 題。
網站只放出其中 5 題的題目跟作答過程,另外 235 題連題目都沒有,標準答案一題都沒公開。所以除了總分本身,其他都可以驗;總分本身沒有人驗得了。
二、「正確」的意思是「跟另外兩個 AI 答得一樣」。
翻它的方法論會發現,這張考卷的標準答案不是人改出來的,是拿 GPT-6 Astra 和 Claude Fable 5.1 兩個模型的作答取平均當標準答案。所以「準確率 61.7%」真正的意思是:有 61.7% 的題目,Jev 答得跟那兩個 AI 一樣。
問題是那兩個 AI 自己就常常答不一樣。在公開的 5 題裡,最後的處置決定只有 2 題是一致的。標準答案自己都對不起來的時候,跟它一不一樣就沒那麼有意義了。
三、同一題問 10 次,答案會變。
我把同一題原封不動連續丟給 Jev 10 次。5 題裡面有 2 題,10 次不會都給同樣的答案——同一份資料,有時候判「通知使用者」,有時候判「交給分析師」。
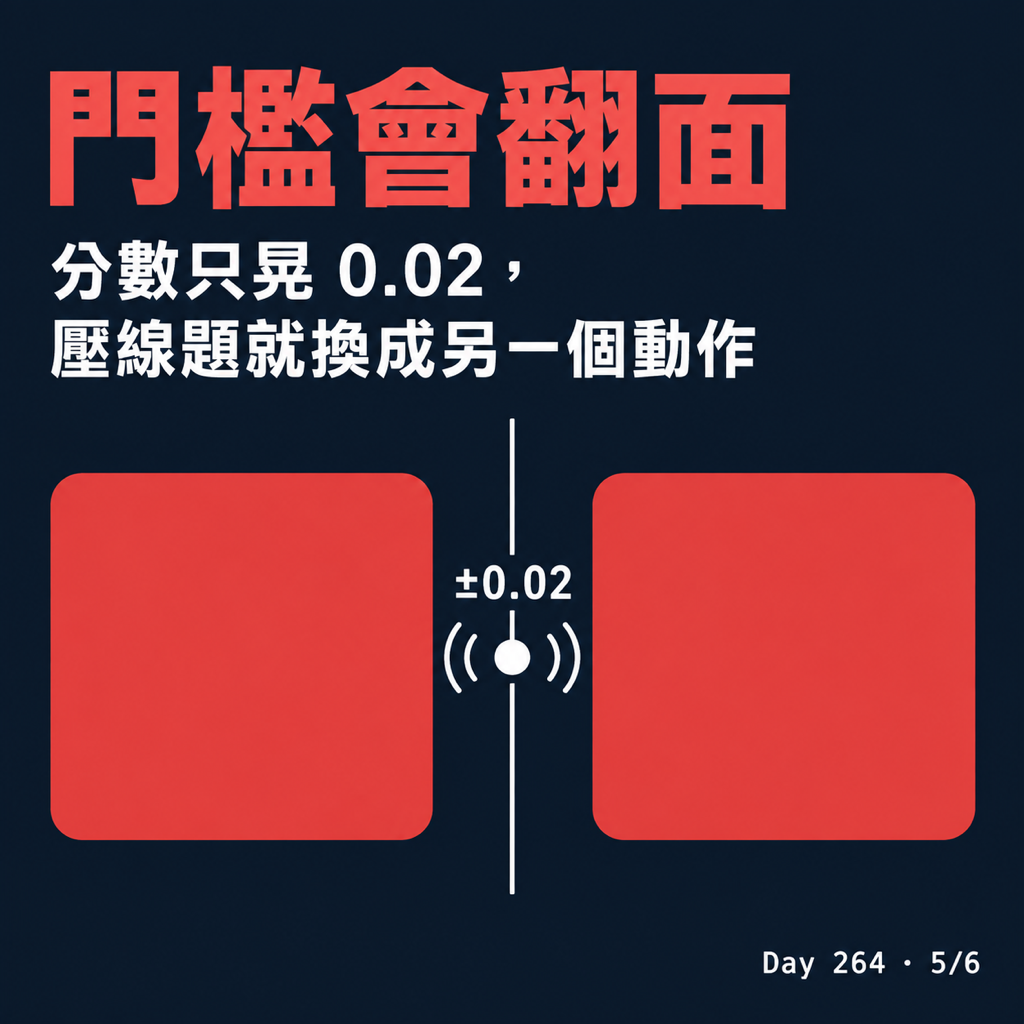
原因在它的運作方式:Jev 只負責給分數,真正決定動作的是外面那段程式碼設的門檻。它給的分數其實很穩,只晃 ±0.02 到 0.04,但那兩題的分數剛好壓在門檻線上,一點點晃動就翻到另一邊。
(公平起見要補一句:這 5 題是網站自己挑出來當範例的,挑的標準就是「各家意見分歧」的題目,本來就特別靠近門檻。240 題的真實比例會比這低。)
67% 其實沒有很驚豔
綜合 67.8% 這個數字,是四項評測分數的算術平均(61.7、61.8、71.6、76.0)。榜首 sol 是 74.1%。
而且在同一張榜上:
- opus 5 73.1%,比 Jev 高
- terra 67.9%,也比 Jev 高
- sonnet 5 67.8%,跟 Jev 完全同分
- luna 66.8%,只差 1 個百分點
有人拿四份公開資料集測 Jev,每份 300 題,同時跟兩個小模型比:
| 題目類型 | 要分幾類 | Jev | gpt-5.4-mini | gpt-5.6-luna |
|---|---|---|---|---|
| 垃圾信判斷 | 2 類 | 98.7 | 97.7 | 98.0 |
| 影評好壞 | 2 類 | 95.7 | 92.7 | 93.0 |
| 新聞分類 | 4 類 | 91.3 | 88.3 | 89.7 |
| 銀行客服意圖 | 77 類 | 76.0 | 78.7 | 81.7 |
看得出來:選項少、每一類界線清楚的題目,Jev 領先一到三個百分點;選項一多(銀行客服那組有 77 種意圖),兩個小模型直接超車。
還有一份 2000 封的釣魚信測試,Jev 62.6%,Claude Haiku 4.5 81.3%,而且 Jev 光是換個問法,分數就差了 5 個百分點。不過同一份測試把問題分成五個是非訊號之後,Jev 拉到 95%,Claude Haiku 4.5 是 93%——直接丟一個大問題給它,本來就不是它的用法。
所以它不是什麼能讓大型語言模型突然變便宜的劃時代發明。小模型在分類這件事上本來就已經很接近了。
那它該擺在哪
它也不是沒有用。
過去要做分類跟決策,我們是拿一個超級聰明、能寫長文的模型去做一件只需要「挑一個」的事——用大砲打小鳥,然後每次都付大砲的錢、等大砲的時間。Jev 證明了「挑一個」這件事,不需要動用到那麼大的模型。
但照現在這個用法,它是一個要我自己接進去、自己去維護、自己去決定有哪些答案的外部服務。我覺得理想的發展方向,是 ChatGPT 和 Claude 自己把這類模型整合進去:當我丟問題給它們、而當下那個判斷的選項是有限又明確的時候,由它們在內部直接走捷徑,我根本不需要知道。
分類值得有一個專門的模型來做。下一步,是讓 ChatGPT、Claude 自己把它包進去。
成績單:https://evals.typesafe.ai/ Jev 文件:https://docs.typesafe.ai/concepts Near Here 活動判斷對比:https://nearhere.events/blog/typesafe-jev-mistral-gemini-event-validation 四份公開資料集與釣魚信測試:https://amankumar.ai/blogs/jev-measured