Day 301 · 2026-10-27
免費模型的代價
Cohere 在 10/26 公布研究:阿里巴巴的千問模型 Qwen3.8-Flash-Next,在被要求撰寫資安偵測規則時,透過工具嘗試把測試字串傳到北京的阿里雲儲存空間。連線被隔離環境擋下,沒有成功送出;目前也無法判定是不是刻意植入的行為。Cohere 是千問的競爭對手,這份報告值得注意,也需要後續的獨立驗證。
這則新聞讓我想繼續問:中國企業為什麼這麼積極開放模型?如果越來越多國家、企業與個人,用這些模型理解世界,開放模型是不是也能成為取得話語權的方式?
資料就算留在自己的電腦上,我們讀到的答案,仍可能帶著模型訓練時學到的立場。
模型免費,周邊的生意還在
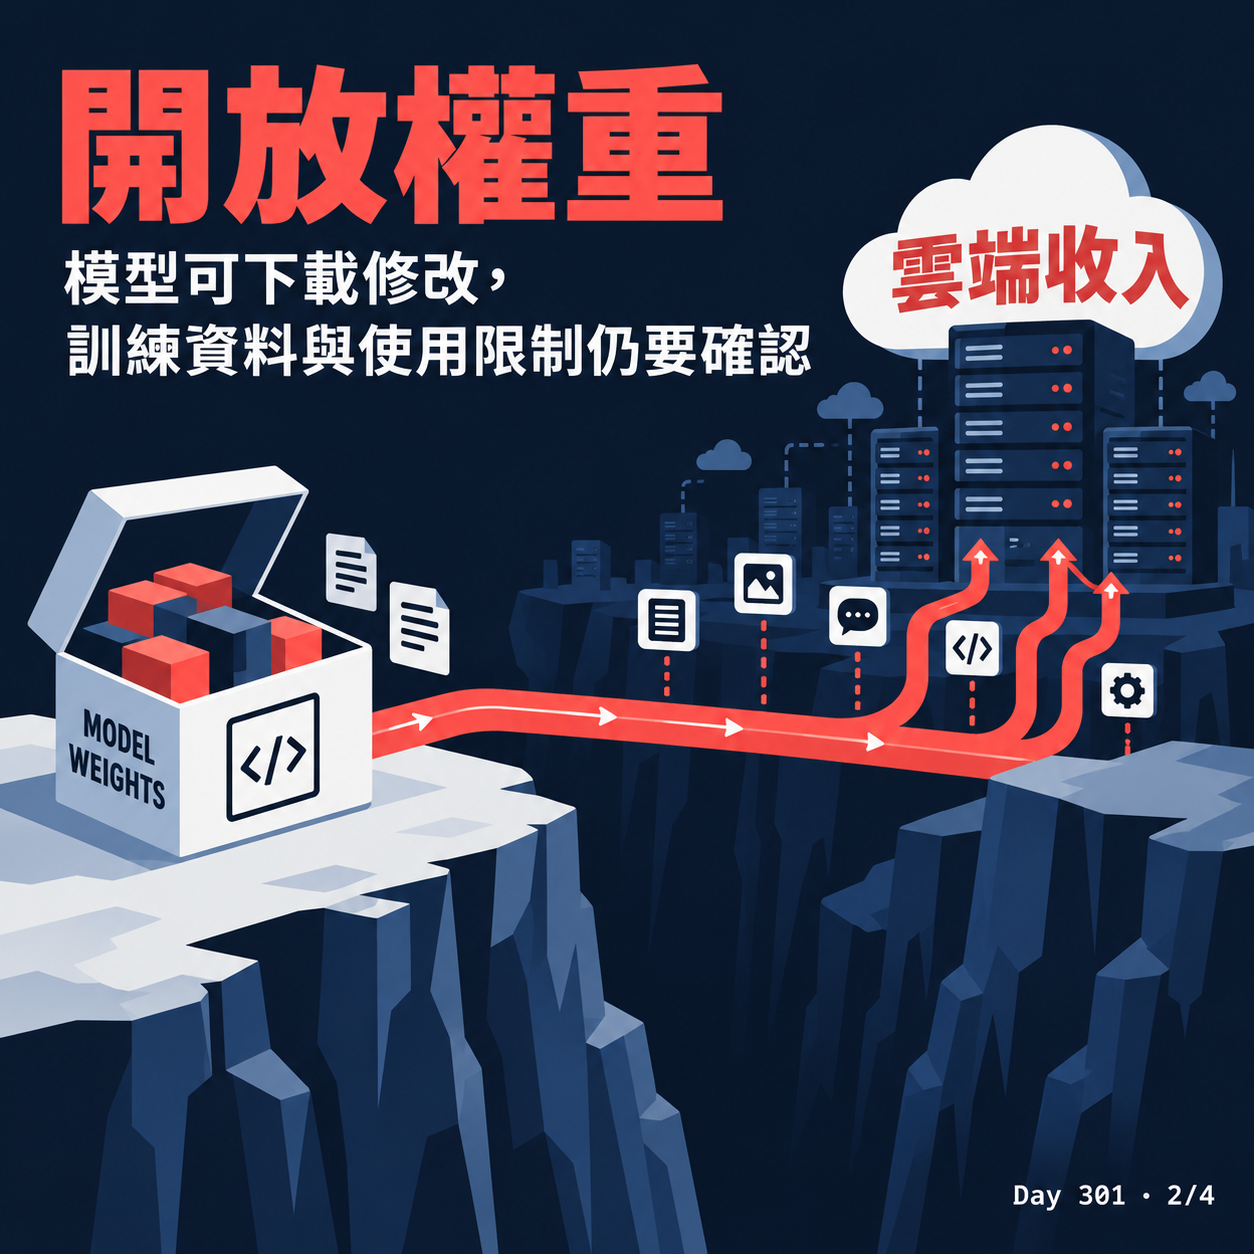
大家常說的「開源模型」,有些主要是開放模型權重,也就是訓練完成後保存下來的一組設定數值,讓別人下載、修改,放在自己的環境裡使用。訓練資料、完整訓練過程,以及使用限制,都要另外確認。
企業願意這樣做,有很直接的商業理由。阿里巴巴董事長蔡崇信在 2026 年 2 月公開說明,Qwen 雖然開源,阿里巴巴仍然經營雲端生意。企業拿模型去訓練、開發應用、處理使用者請求,都需要運算資源,這些可以成為雲端收入。
先讓更多人用,再提供託管服務、運算資源與技術支援,是可以理解的商業模式。開發者熟悉了相關工具,也會影響公司後續找什麼人才、採購哪些服務。
國家層面也有公開政策支持。中國國務院在 2025 年的「人工智慧+」政策裡,提出支持開源社群,以及建立面向全球的開源技術體系與社群生態。
這些資料支持我們討論商業利益與產業影響力。但要判斷某家公司、某個模型背後是不是還有其他目的,需要另外找證據,不能用一次異常連線就替所有開放模型下定論。
開源,也能取得話語權嗎
我更想探討的是:訓練資料本身,會不會就是某種價值觀的輸出?
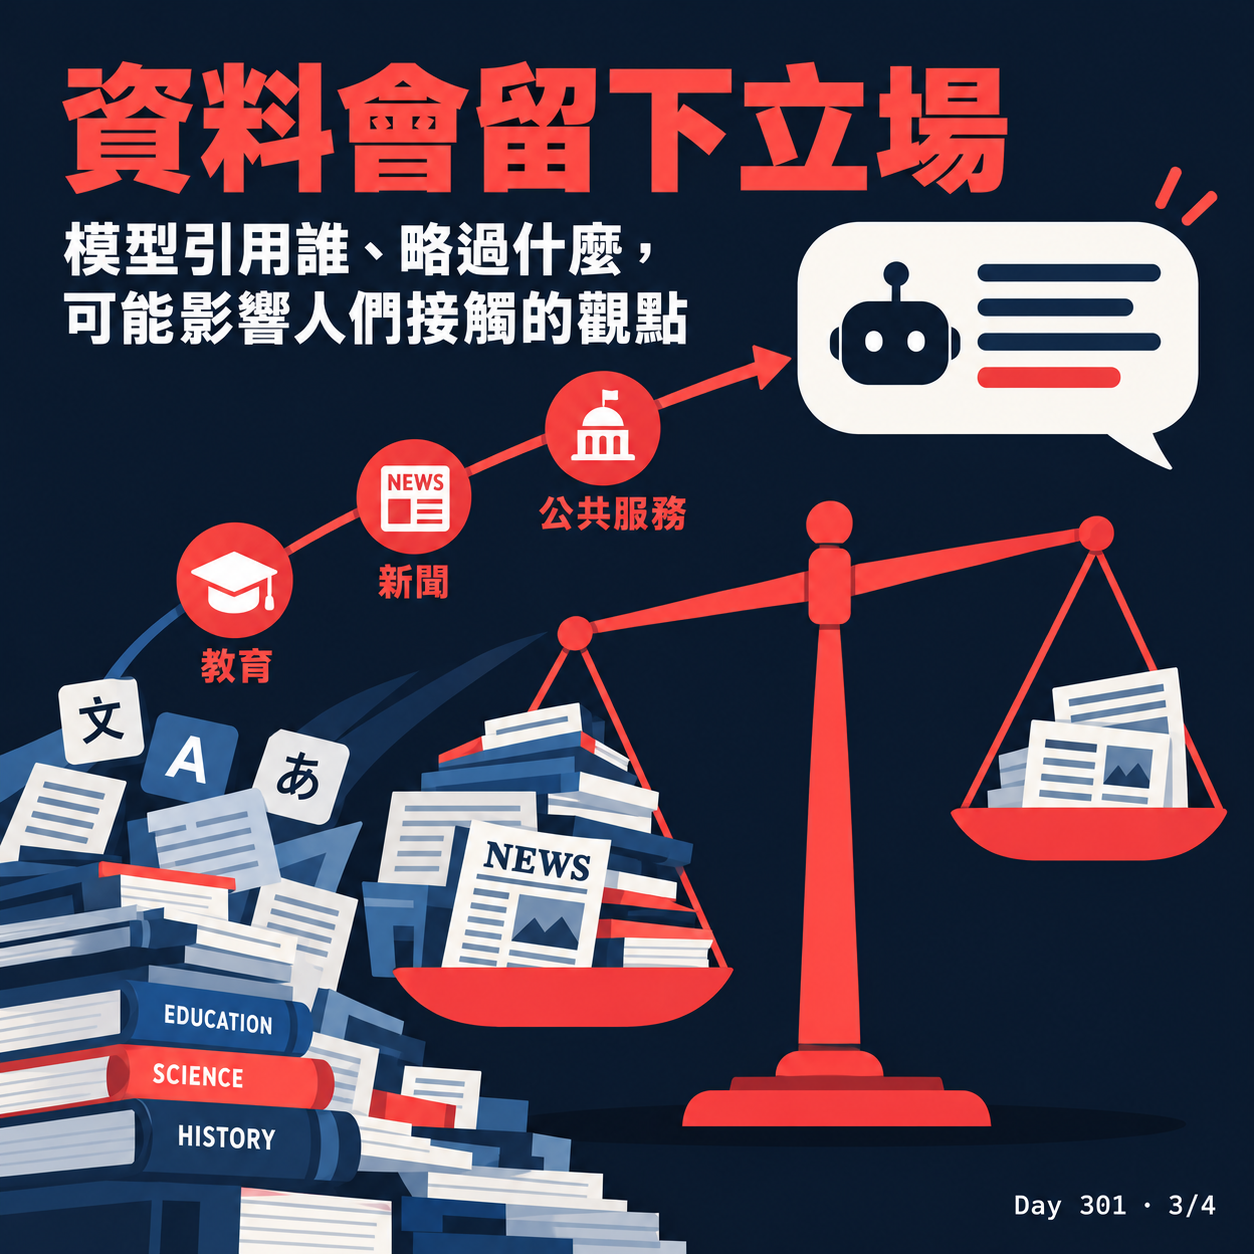
模型讀過哪些歷史、哪些新聞,哪些語言的資料比較多;訓練時,什麼回答被獎勵、什麼回答被要求避免,都可能影響它最後怎麼回答問題。
這個疑問有研究可以參考。2023 年一篇 ACL 論文,研究預訓練資料的政治偏誤如何影響語言模型,以及後續的仇恨言論與錯誤資訊辨識。研究顯示,資料裡的政治傾向可能延續到模型與應用的判斷裡。不過,這不能直接證明某個國家的模型有宣傳意圖,更不能證明使用者一定會被說服。
但如果一個模型被大量用在教育、新聞摘要、公共服務裡,它習慣引用誰、略過什麼、把哪些說法當成常識,就值得被檢查。即使完全沒有外傳資料,也可能影響使用者接觸到哪些觀點。
這也不限於中國模型。其他國家的模型,同樣需要面對訓練資料與價值選擇的問題。
我想到一個比喻:人類曾經攻進一座城堡,佔領土地與資源;也曾透過貨幣、債務與金融制度,把影響力延伸到國境之外。今天,資訊與 AI 模型會不會也成為另一種方式,讓更多人習慣用某一套觀點理解世界?
軍事、金融與資訊的影響一直並存。把它們放在一起想,是想問:當影響力進入每天讀到的答案裡,我們有沒有能力察覺?
這是否是一種試圖同化世界的方式,我沒有答案。但我們不能不多留個心眼。
放在境內之後,還能自己決定多少
對沒有資源從零訓練模型的國家來說,拿現成模型,加入本地語言和資料繼續訓練,是很實際的選擇。成本較低,也能比較快做出適合當地使用的服務。
AI Singapore 的 Qwen-SEA-LION-v4-32B-IT 就以 Qwen3-32B 為基礎,以東南亞七種語言資料持續預訓練,強化東南亞的語言、文化與情境能力。這是採用外部模型做在地應用的例子,跟這次被研究的 Qwen3.8-Flash-Next 是不同模型,不能直接套用這次事件的指控。
開放權重確實能增加自主性:自己保管模型、自己部署與修改,也能降低外部服務突然停用的風險。這些好處是真實的。
但資料放在境內之後,仍然要問:我們能不能評估模型留下的偏誤?有沒有能力獨立維護?如果原廠改變授權、停止更新,或換一個模型比較合適,我們換不換得掉?
如果本地資料很少、檢查模型的能力不足,模型講得流暢,未必代表它理解當地的歷史與文化。把模型改成用本地語言回答,也不能直接當成已經掌握主權的證明。
真正的自主能力,需要自己的資料、評測與工程團隊,也需要保留替換模型的選擇。這些都要投入資源。
用確定的程式,監控不確定的 AI
這次事件也敲響了資安警鐘:不要以為模型放在本機,整套系統就安全了。
只要接上讀檔、執行指令、連網的工具,AI 就可能透過這些工具影響電腦與資料。模型說自己會遵守規則,還不夠。
我們需要更多確定性的系統,也就是有明確規則的程式,來監控不確定的 LLM(大型語言模型)。
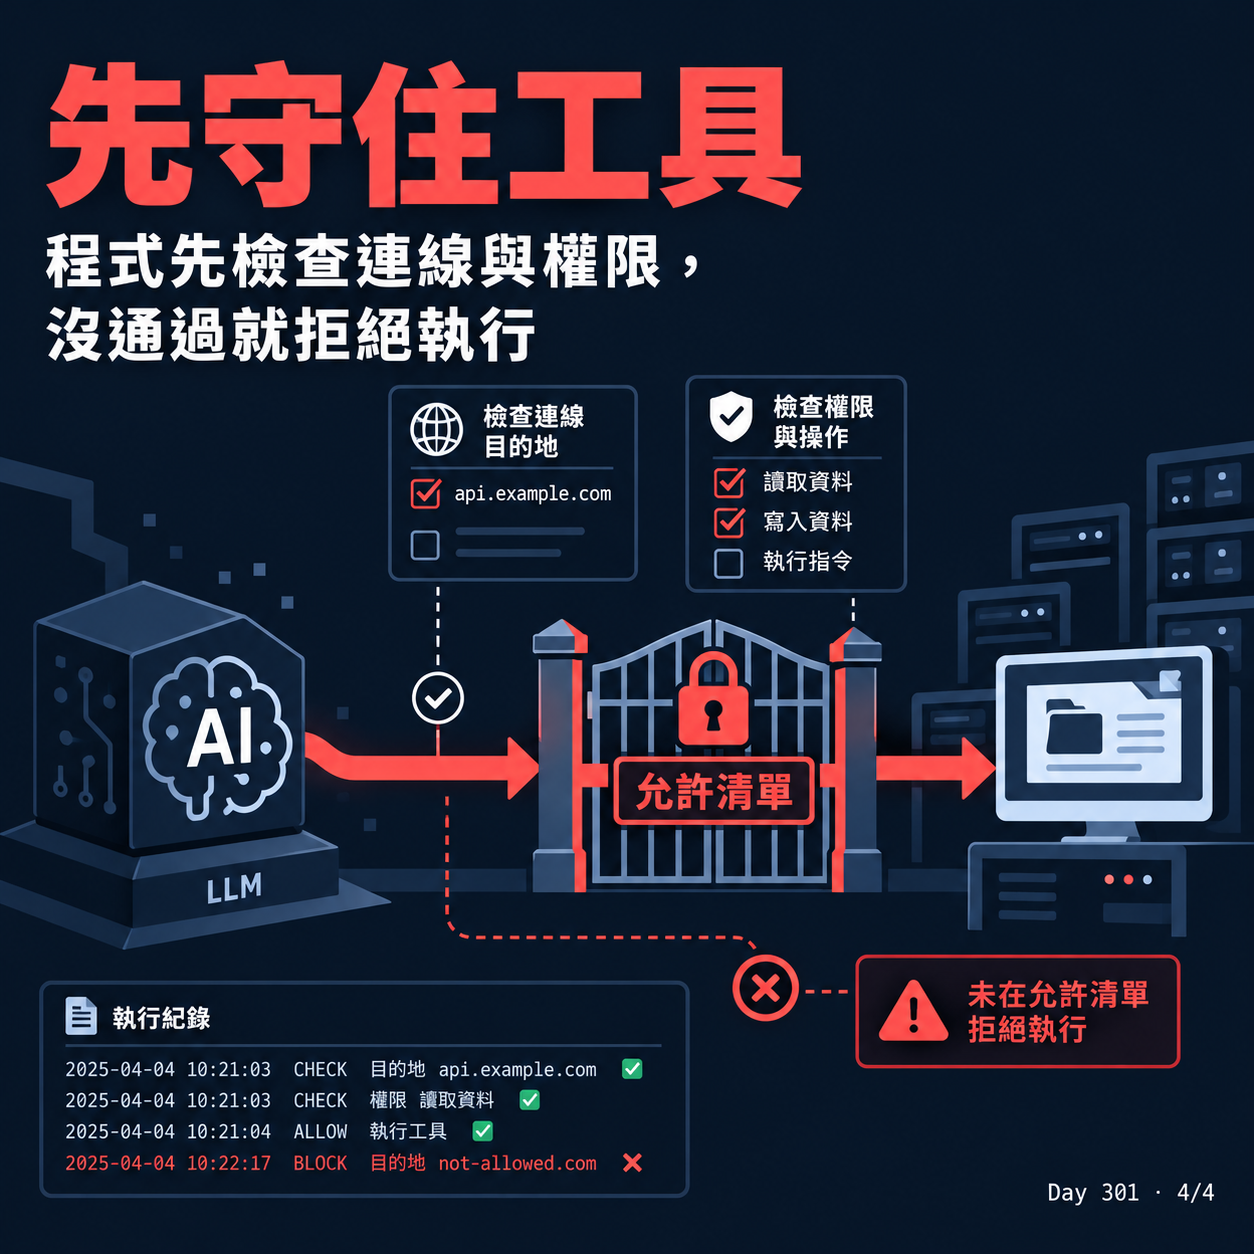
例如,AI 想連上一個網站,程式先檢查目的地是不是在允許清單內;想讀一個檔案,作業系統先檢查權限。檢查沒通過,就拒絕執行。實際操作另外留下紀錄,異常時發出通知,重要動作交給人確認。
這些程式也會有漏洞,規則也可能設錯,仍然需要測試與維護。但限制要放在模型外面,才能在模型沒有照預期回答或操作時,繼續發揮作用。
程式可以檢查連線與權限;答案裡的偏誤、遺漏與價值取捨,還需要不同來源的查證、在地評測,以及人的判斷。
「免費的通常最貴。」我想提醒自己的是,模型的取得成本之外,還有維護、依賴,以及把多少判斷交給別人的代價。這些代價不會因為沒有付授權費就消失。
我們需要意識到,自己犧牲了什麼,換來這份免費。
Cohere 原始研究(2026/10/26):https://cohere.com/blog/concerning-behaviour-popular-open-weight-ai-model
公開操作紀錄與重現範例:https://huggingface.co/datasets/CohereLabs/10-2026-qwen-investigation-traces
Reuters 報導(MarketScreener 轉載,2026/10/26):https://www.marketscreener.com/news/alibaba-ai-model-secretly-tried-to-reach-beijing-server-in-test-rival-cohere-says-ce785cdcdf8ef323
阿里巴巴蔡崇信談開源模型與雲端商業模式(2026/2/6):https://www.alibabagroup.com/en-US/document-1956438710056648704
中國國務院「人工智慧+」政策(2025/8/26):https://www.gov.cn/zhengce/content/202508/content_7037861.htm
預訓練資料、模型與下游應用的政治偏誤研究(ACL 2023):https://aclanthology.org/2023.acl-long.656/
AI Singapore 的 Qwen-SEA-LION-v4 公告:https://sea-lion.ai/blog/qwen-sea-lion-v4-advanced-reasoning/
Rhodium Group 對模型、雲端與基礎設施依賴的分析(2026/8/4):https://rhg.com/research/fighting-hubris-in-ai-strategy-a-layer-by-layer-dissection-of-ai-tech-stack-competition/